Status: GPU-Lüfter auf Volllast, VRAM-Belegung im Grenzbereich, Kaffeekonsum ebenfalls. Während das System bisher „nur” ein 27B-Modell strammstehen ließ, wurde es heute architekturell ernst. VRAM-Management ist eben nicht nur das Anpassen eines Context-Windows. Das merkt man spätestens, wenn zwei gigantische LLMs sich dieselben drei Grafikkarten im fliegenden Wechsel teilen sollen.
Phase 1: Die vLLM-Fata-Morgana
An vLLM kommt man in den einschlägigen Subreddits und Tech-Feeds kaum vorbei: höchster Durchsatz, PagedAttention, der heilige Gral der Enterprise-Inferenz. Grund genug, dem Framework eine Chance auf meinem abliterated Qwen3.8-27B zu geben. Die Voraussetzungen schienen ideal: 3x Nvidia Tesla T10 (48 GiB VRAM total, Turing/sm_75) und die Rechenpower meines 32-Core AMD EPYC. Plan: maximalen Token-Durchsatz abgreifen. Turing-Silizium holt gehypte Paper-Benchmarks aber schneller auf den Boden der Tatsachen zurück als ein unbarmherziger OOM-Killer im Prod-Namespace.
Der Realitätscheck kam prompt. Erstens: Das Hybrid-Attention-Design des Modells schickt nur 16/4 KV-Heads ins Rennen, und die sauber auf 3 GPUs aufzuteilen funktioniert bei vLLM mathematisch schlicht nicht: Tensor-Parallelismus verweigert augenblicklich den Dienst (auf llama.cpp klappt exakt dieselbe Aufteilung interessanterweise klaglos). Der erzwungene Ausweich auf Pipeline-Parallelismus wird sofort mit teurer Cross-GPU-Bubble-Latenz bezahlt. Zweitens wollte vLLMs Community-GGUF-Plugin mit der Architektur nicht kooperieren. Also raus auf einen nativen HF-FP8-Checkpoint. Klingt gut, treibt Turing-Karten ohne native FP8-Einheiten aber nur Tränen in die Shader-Cores. Dass Vision am Ende überhaupt ein Lebenszeichen von sich gab, lag an einem undokumentierten Flag (–mm-encoder-attn-backend TORCH_SDPA), vergraben tief in den Kommentaren eines ungemergten Pull Requests.
Ergebnis des Ausflugs: vLLM lieferte am Ende mikrige 50% der Decode-Performance von llama.cpp. Kein Deal. Das Framework flog achtkantig aus dem Stack, zumindest bis GPU Nummer 4 im Rack sitzt und die Tensor-Parallel-Mathematik wieder aufgeht.
Phase 2: Das 116-GB-Monster ins 48-GB-Korsett zwängen
Nach der vLLM-Pleite ging es an das eigentliche Schwergewicht des Abends: Qwen3.8-Flash-Next (177B MoE, 512 Experts, 116 GB als Q4_K_M auf der NVMe). Dafür brauchte es zwei Dinge: CPU-Offloading und ein paar Custom Builds.
Das eingebaute CPU-Offloading von llama.cpp ignorierte stur mein –tensor-split und packte alle GPU-Layer auf eine einzige Karte. Resultat: Instant OOM. Geholfen hat am Ende nur handgeschriebenes Regex-Voodoo über –override-tensor, das die Transformer-Layer explizit namentlich auf die drei GPUs verteilt. Beim Speculative Decoding stürzte der offizielle MTP Draft-Head auf Mainline-llama.cpp zuverlässig ab; gerettet hat nur Selbst-Kompilieren direkt aus dem Entwickler-Branch von Unsloth, danach schoss der Decode-Speed spürbar nach oben. Und beim Kontext gab’s noch eine Überraschung: Weil Linear-Attention feste Recurrent-States nutzt, kostet mehr Kontext scheinbar null zusätzlichen VRAM, bis das System bei 131.072 Tokens im Top-K-Kernel des Routers hart abschmierte. Per Binärsuche kam die reale Obergrenze raus: 98.304 Tokens, mehr geht ohne zusätzliches Layer-Offloading nicht.
Das eigentliche Highlight kam beim Temperaturvergleich, und zwar andersrum, als man erwarten würde. Beim dichten 27B-Modell mit Tensor Split brüllen alle drei GPUs auf 100% Volllast, rennen gnadenlos ins Thermal Throttling und krebsen drosselungsbedingt bei 19-20 t/s herum. Beim 177B-MoE-Modell mit Layer Split dagegen schaltet das System auf entspanntes Cruisen um: Die GPUs bleiben bei gemütlichen 65°C Peak, drosseln kein einziges MHz und liefern dank Speculative Decoding trotzdem 22 bis 25,6 t/s. Kühleres Silizium, kein Throttling, mehr Durchsatz. Das kleinere Modell quält die Hardware mehr als das große.
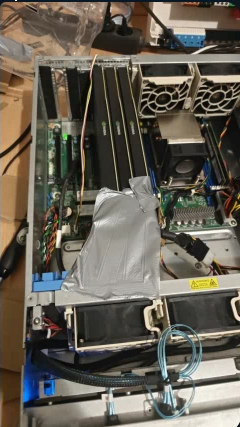
Low-Tech Air Duct für High-Tech Silizium: Wenn das Panzertape (Duct Tape) zum echten Air Duct wird. Wer braucht schon 3D-Drucker, wenn die Aerodynamik auch mit SRE-Standardwerkzeug stimmt?
Phase 3: Der intelligente Türsteher
Damit beide Modelle sich dieselben drei Grafikkarten überhaupt teilen können, musste mein selbstgebauter Scale-to-Zero-Proxy (llama-activator, Python/aiohttp) nachrüsten. Er liest das “model”-Feld direkt aus dem OpenAI-Payload und routet entsprechend. Bei einem Modellwechsel stoppt er den aktiven Docker-Container. Weil Docker beim Stoppen blockiert, ist garantiert, dass der VRAM zu 100% frei ist, bevor das neue Modell hochfährt. Parallele Anfragen auf ein kaltes Modell bündelt ein asyncio-Lock, sodass drei zeitgleiche Prompts genau einen Switch auslösen, nicht drei. Verifiziert unter echter Produktionslast über die Kette Traefik → Proxy → llama.cpp.
Ergebnis in Zahlen
| Metrik | Qwen3.8-27B (Dense) | Qwen3.8-Flash-Next (MoE, 177B/11 Active) |
|---|---|---|
| Decode Speed | ~19-20 t/s (Thermal Throttling) | ~22-25,6 t/s (65°C Peak, kein Throttling) |
| Context Window | 262.144 Tokens (Native Max) | 98.304 Tokens (Empirisches VRAM-Limit) |
| GPU Footprint | ~41 GiB / 48 GiB | ~45 GiB / 48 GiB (Experts im RAM) |
Klingt nach viel Bastelei für zwei Modelle, aber für das Fundament von Synapse-CNC gibt’s keine Kompromisse. Der Weg ist frei, die Modelle tauschen fliegend.
Ausblick
Beim Flashen von Microcontrollern bleibt’s jedenfalls nicht. Analog zur DSH WebUSB Bridge schraube ich gerade an einer MCP Server Bridge: ein lokaler MCP-Proxy, isoliert im Docker-Container, direkt über die Browser-Schnittstelle steuerbar. Der Agent kriegt damit sein nächstes universelles Protokoll-Werkzeug, um noch tiefer in lokale Subsysteme reinzugreifen.
Status: System läuft. Keine Latenz. Keine Kompromisse.
